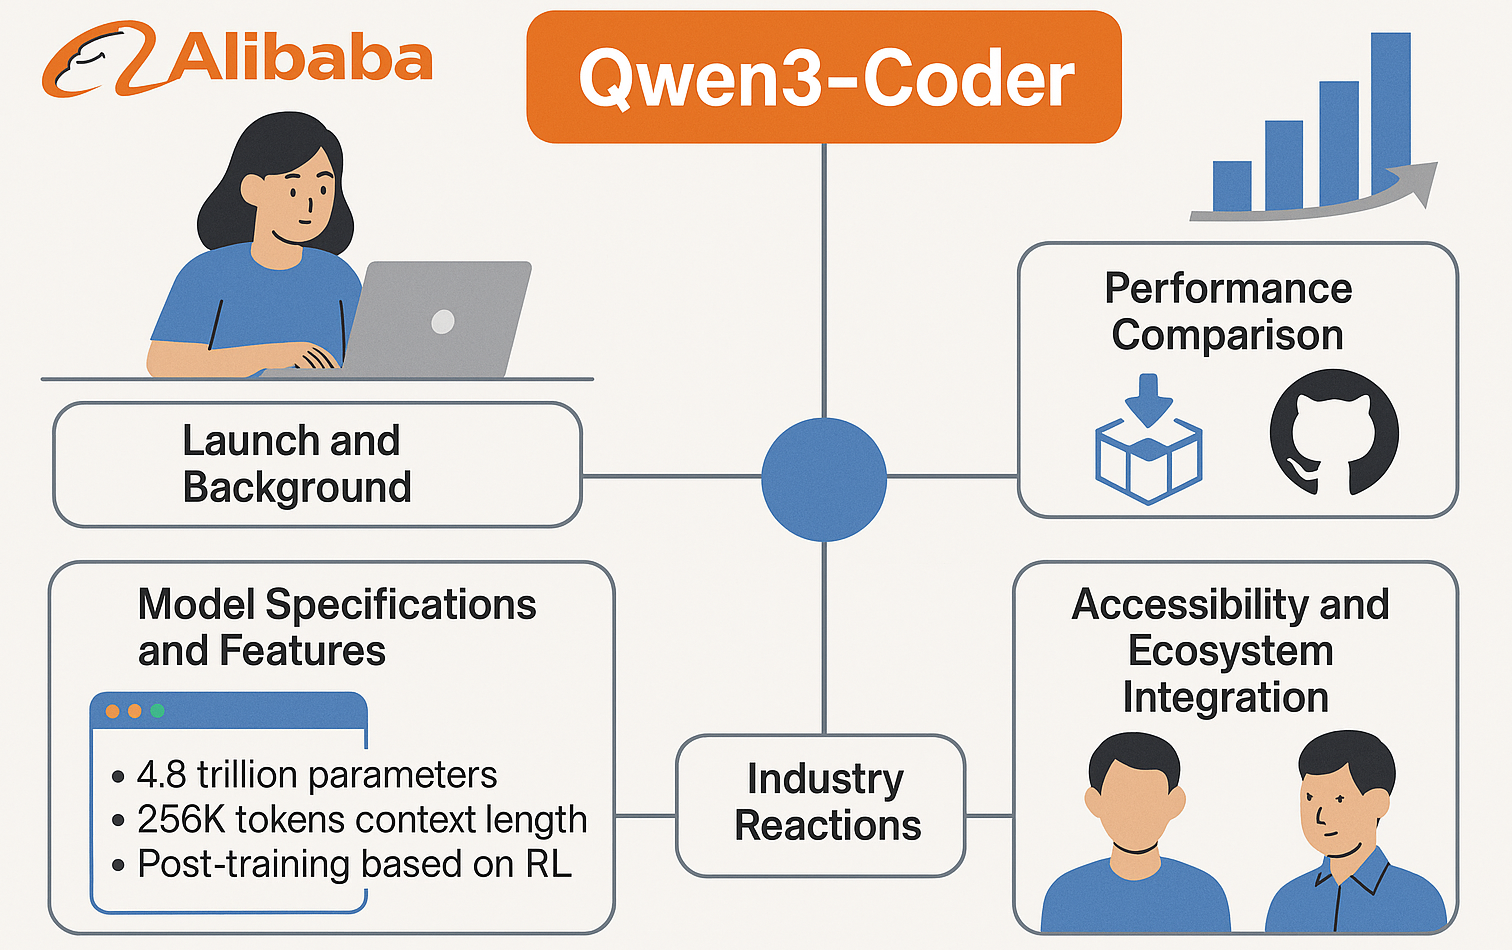
― 초거대 오픈소스 AI 코딩 모델의 성능, 활용법, 그리고 보안 가이드
개요 및 배경
● 무엇이 발표되었나?
- 2025년 7월, 알리바바 그룹 산하의 인공지능 연구소에서 오픈소스 코딩 특화 AI 모델 Qwen3‑Coder를 출시.
- 가장 큰 특징은 GPT-4 수준의 성능을 제공하면서도 오픈소스로 상업적 이용까지 허용한다는 점.
● 왜 중요한가?
- 기존 GPT-4, Claude, Gemini 등은 대부분 상용 서비스에 종속되거나 사용 제약이 있음.
- Qwen3-Coder는 누구나 다운로드하고 로컬 또는 자체 인프라에 설치해 사용할 수 있음 → 기업 내부 개발 보조, 자동화, 보안 분석 등 다양한 분야로 확장 가능.
● 핵심 가치 제안
- ✅ 오픈소스: Apache 2.0 라이선스로 상업적 사용 자유
- ✅ 고성능: GPT-4, Claude 수준의 코딩 능력
- ✅ 대규모 컨텍스트: 최대 100만 토큰 지원
- ✅ Agentic AI: 자율적 코딩 작업 수행 가능
● 개발 배경
알리바바는 급성장하는 AI 코딩 어시스턴트 시장에서 오픈소스 생태계를 주도하기 위해 Qwen3-Coder를 개발했습니다. 개발자 부족과 효율성 요구로 인해 AI 프로그래밍 어시스턴트 시장이 빠르게 확장되고 있으며, Microsoft, OpenAI, Google, Amazon 등 주요 기업들이 코딩 작업 자동화를 위해 경쟁하고 있는 상황에서 출시되었습니다.
● 개발 철학
경쟁적 수준의 코드 생성에만 집중하는 커뮤니티의 일반적인 접근과 달리, 모든 코드 작업이 실행 중심의 대규모 강화학습에 자연스럽게 적합하다고 믿는 철학으로 개발되었습니다.
● 주요 마일스톤
- 2024년 6월: Tongyi Lingma 출시 이후 30억 줄 이상의 코드 생성
- 2025년 7월: Qwen3-Coder 공식 발표
- 현재: Qwen 기반 코딩 모델 전 세계 2천만 다운로드 돌파
모델 사양 및 기술적 특징
| 항목 | 내용 |
| 모델명 | Qwen3‑Coder‑480B‑A35B‑Instruct |
| 모델 크기 | 4,800억 파라미터 (MoE 기반, 선택적으로 활성화되는 파라미터 수: 약 350억) |
| 컨텍스트 길이 | 기본 256K tokens (최대 1M tokens 확장 가능) |
| 지원 언어 | Python, Java, C, C++, Go, Rust, JavaScript, SQL 등 다수 |
| 학습 방식 | RLHF (강화학습 기반 사후 훈련), Code RL, Long-Horizon Agent RL 포함 |
| 토큰화 방식 | Tiktoken (OpenAI 방식과 유사) |
MoE (Mixture of Experts) 구조
- 총 파라미터: 480B (4,800억)
- 활성 파라미터: 35B (350억) - 추론 시
- 전문가 구성: 160개 전문가, 추론당 8개 활성화
- 효율성: 전체 모델의 7.3%만 활성화하여 연산 효율 극대화
- 확장성: 필요에 따라 전문가 추가 가능
- 특화성: 각 전문가가 특정 도메인에 최적화
컨텍스트 처리 능력
| 구분 | 토큰 수 | 용도 |
|---|---|---|
| 네이티브 | 256,000 | 일반적인 대규모 프로젝트 |
| 확장 (YaRN) | 1,000,000 | 초대형 코드베이스, 문서 |
학습 데이터 및 방법론
사전학습 (Pre-training)
- 데이터 규모: 7.5조 토큰
- 코드 비율: 70%
- 언어 다양성: 119개 언어 및 방언 지원
강화학습 (Reinforcement Learning)
Code RL과 Long-Horizon Agent RL을 통해 실제 소프트웨어 개발 환경에서 학습
- 환경 규모: 20,000개 독립 환경 병렬 실행
- 학습 방식: 다단계 작업 수행 및 피드백 기반 개선
- 인프라: 알리바바 클라우드 활용
지원 프로그래밍 언어
Python, JavaScript, Java, C++, Go, Rust 등 다양한 프로그래밍 언어를 포함하여
주류 언어: Python, JavaScript, TypeScript, Java, C++, C#, Go, Rust, Swift, Kotlin
웹 기술: HTML, CSS, PHP, Ruby
시스템 언어: Assembly, Bash, PowerShell
데이터/과학: R, MATLAB, Julia, SQL
기타: Haskell, Scala, Dart, Perl, Lua 등
SWE‑Bench 성능 평가 (GitHub 이슈 + PR 기반 실무형 코딩 테스트 기준)
| 모델 | 정답률 | 비고 |
| Claude 3 Sonnet | 70.4% | 가장 높은 상용 모델 중 하나 |
| Qwen3-Coder | 67.0% | 오픈소스 모델 중 최고 성능 |
| GPT-4.1 | 54.6% | OpenAI 최신 상용 모델 |
| Gemini 2.5 | 49.0% | Google 최신 모델 |
➡️ 오픈소스 모델 중 거의 유일하게 GPT-4 및 Claude와 견줄 수준의 결과를 냄.
- 코드 생성: 복잡한 알고리즘과 전체 애플리케이션 생성 가능
- 코드 수정: 기존 코드의 버그 수정 및 리팩토링
- 코드 이해: 대규모 코드베이스 분석 및 문서화
- 다국어 지원: 40개 이상 프로그래밍 언어에서 우수한 성능
접근성과 생태계 통합
● 다운로드 및 실행 방법
- Hugging Face: https://huggingface.co/Qwen/Qwen3-Coder-14B
- GitHub: https://github.com/QwenLM/Qwen
- CLI 도구: qwen-code 제공 → 터미널에서 직접 프롬프트 입력 및 코드 생성 가능
● 도구 통합 예시
| 통합 대상 | 활용 예시 |
| VSCode | 확장 프로그램으로 자동 코드 생성 및 보완 |
| Jupyter Notebook | 대규모 코드 작성 지원, 주석 자동 생성 |
| CI/CD 파이프라인 | 코드 리뷰 자동화, 테스트 시나리오 생성 |
다운로드 및 설치 옵션
1) Hugging Face
# pip를 통한 transformers 설치
pip install transformers>=4.51.0

# Python에서 모델 로드
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "Qwen/Qwen3-Coder-480B-A35B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_name)
2) 알리바바 클라우드 API
from openai import OpenAI

client = OpenAI(
    api_key="your_dashscope_api_key",
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
)

response = client.chat.completions.create(
    model="qwen3-coder-plus",
    messages=[{"role": "user", "content": "Python으로 퀵소트 구현"}]
)
Qwen Code CLI 도구
Gemini Code에서 포크되어 Qwen-Coder 모델용으로 최적화된 CLI 도구
# 설치
npm install -g qwen-code

# 환경 변수 설정
export OPENAI_API_KEY="your_api_key"
export OPENAI_BASE_URL="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
export OPENAI_MODEL="qwen3-coder-plus"

# 사용
qwen
IDE 통합
VS Code Extension 설정
{
  "qwen.apiKey": "your_api_key",
  "qwen.model": "qwen3-coder-plus",
  "qwen.baseUrl": "https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
}
Cline 통합
OpenAI Compatible API Provider 선택 후 커스텀 베이스 URL 입력
업계 반응 및 평가
전문가 평가
- 세바스찬 라슈카 (위스콘신대 AI 연구자): "지금까지 나온 최고의 오픈 가중치 코딩 모델"
- 울프람 레이븐울프 (EllamindAI): "현재 사용 가능한 최고의 모델"
- 찰리 다이 (Forrester VP): "SWE-Bench에서의 뛰어난 agentic 능력은 코딩 워크플로우 자동화를 위한 완전히 위임된 TuringBots로의 전환을 시사"
커뮤니티 반응
- GitHub Stars: 급속 증가 중
- HuggingFace: 인기 데모 2위
- 개발자 포럼: 긍정적 피드백 다수
실전 활용 가이드
기본 코드 생성
# 예제 1: 알고리즘 구현
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "Qwen/Qwen3-Coder-480B-A35B-Instruct"
model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
tokenizer = AutoTokenizer.from_pretrained(model_name)

# 프롬프트 준비
prompt = """
이진 탐색 트리를 구현하고 다음 기능을 포함하세요:
1. 삽입 (insert)
2. 검색 (search)
3. 삭제 (delete)
4. 중위 순회 (inorder traversal)
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
inputs = tokenizer([text], return_tensors="pt").to(model.device)

# 코드 생성
outputs = model.generate(**inputs, max_new_tokens=2048, temperature=0.7)
response = tokenizer.decode(outputs[0][len(inputs.input_ids[0]):], skip_special_tokens=True)
print(response)
코드 리뷰 및 개선
# 예제 2: 기존 코드 리뷰
code_to_review = """
def fibonacci(n):
    if n <= 1:
        return n
    return fibonacci(n-1) + fibonacci(n-2)
"""

prompt = f"""
다음 코드를 리뷰하고 개선점을 제안해주세요:

{code_to_review}

특히 다음 관점에서 분석해주세요:
1. 성능 최적화
2. 메모리 효율성
3. 가독성
4. 에러 처리
"""

# API를 통한 코드 리뷰
response = client.chat.completions.create(
    model="qwen3-coder-plus",
    messages=[{"role": "user", "content": prompt}],
    temperature=0.3
)
Fill-in-the-Middle (FIM)
# 예제 3: 코드 자동 완성
fim_prompt = """<|fim_prefix|>def merge_sort(arr):
    if len(arr) <= 1:
        return arr

    mid = len(arr) // 2
    left = merge_sort(arr[:mid])
    right = merge_sort(arr[mid:])

<|fim_suffix|>
    return result

# 테스트
test_array = [64, 34, 25, 12, 22, 11, 90]
sorted_array = merge_sort(test_array)
print(f"정렬된 배열: {sorted_array}")<|fim_middle|>"""

messages = [
    {"role": "system", "content": "You are a code completion assistant."},
    {"role": "user", "content": fim_prompt}
]
도구 통합 (Function Calling)
# 예제 4: 도구 정의 및 사용
tools = [{
    "type": "function",
    "function": {
        "name": "execute_sql_query",
        "description": "SQL 쿼리를 실행하고 결과를 반환합니다",
        "parameters": {
            "type": "object",
            "required": ["query"],
            "properties": {
                "query": {
                    "type": "string",
                    "description": "실행할 SQL 쿼리"
                }
            }
        }
    }
}]

# 도구를 활용한 대화
completion = client.chat.completions.create(
    model="qwen3-coder-plus",
    messages=[
        {"role": "user", "content": "고객 테이블에서 최근 30일간 가입한 사용자 수를 조회해줘"}
    ],
    tools=tools,
    tool_choice="auto"
)
고급 활용 시나리오
대규모 리포지토리 분석
# 전체 프로젝트 구조 분석
import os
import glob

def analyze_repository(repo_path):
    # 모든 Python 파일 수집
    python_files = glob.glob(f"{repo_path}/**/*.py", recursive=True)

    # 코드 결합 (주의: 토큰 제한 고려)
    combined_code = ""
    for file_path in python_files[:10]:  # 처음 10개 파일만
        with open(file_path, 'r') as f:
            combined_code += f"\n# File: {file_path}\n"
            combined_code += f.read() + "\n\n"

    prompt = f"""
    다음 프로젝트 코드를 분석하고:
    1. 전체 아키텍처 요약
    2. 주요 디자인 패턴
    3. 개선 제안사항
    을 제공해주세요.

    {combined_code}
    """

    return prompt
자동화된 테스트 생성
# 주어진 함수에 대한 단위 테스트 자동 생성
function_code = """
def validate_email(email: str) -> bool:
    import re
    pattern = r'^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$'
    return re.match(pattern, email) is not None
"""

test_prompt = f"""
다음 함수에 대한 포괄적인 pytest 테스트를 작성하세요:

{function_code}

다음을 포함해야 합니다:
1. 정상 케이스
2. 엣지 케이스
3. 에러 케이스
4. 파라미터화된 테스트
"""
CI/CD 파이프라인 통합
# .github/workflows/code-review.yml
name: AI Code Review

on:
  pull_request:
    types: [opened, synchronize]

jobs:
  ai-review:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3

      - name: Setup Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.10'

      - name: AI Code Review
        env:
          QWEN_API_KEY: ${{ secrets.QWEN_API_KEY }}
        run: |
          python scripts/ai_code_review.py \
            --diff "${{ github.event.pull_request.diff_url }}" \
            --model "qwen3-coder-plus"
실시간 코딩 어시스턴트
# 대화형 코딩 세션
class InteractiveCodingAssistant:
    def __init__(self, api_key):
        self.client = OpenAI(
            api_key=api_key,
            base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
        )
        self.conversation_history = []
        self.code_context = {}

    def add_code_context(self, filename, code):
        """코드 컨텍스트 추가"""
        self.code_context[filename] = code

    def ask(self, question):
        """질문에 대한 응답 생성"""
        # 컨텍스트 준비
        context = "현재 작업 중인 코드:\n"
        for filename, code in self.code_context.items():
            context += f"\n--- {filename} ---\n{code}\n"

        # 메시지 구성
        messages = self.conversation_history + [
            {"role": "system", "content": context},
            {"role": "user", "content": question}
        ]

        # 응답 생성
        response = self.client.chat.completions.create(
            model="qwen3-coder-plus",
            messages=messages,
            max_tokens=4096
        )

        # 히스토리 업데이트
        self.conversation_history.extend([
            {"role": "user", "content": question},
            {"role": "assistant", "content": response.choices[0].message.content}
        ])

        return response.choices[0].message.content

# 사용 예
assistant = InteractiveCodingAssistant(api_key="your_key")
assistant.add_code_context("main.py", open("main.py").read())
response = assistant.ask("이 코드의 성능을 개선하려면 어떻게 해야 할까요?")
보안 고려사항
1) API 키 관리
# 환경 변수 사용
import os
from dotenv import load_dotenv

load_dotenv()
api_key = os.getenv("QWEN_API_KEY")

# HashiCorp Vault 등 시크릿 관리 도구 활용
from hvac import Client

vault = Client(url='https://vault.company.com')
api_key = vault.read('secret/qwen')['data']['api_key']
2) 데이터 보안
# 민감 정보 필터링
def sanitize_code(code):
    # API 키, 비밀번호 등 제거
    import re
    patterns = [
        (r'api_key\s*=\s*["\'].*?["\']', 'api_key="[REDACTED]"'),
        (r'password\s*=\s*["\'].*?["\']', 'password="[REDACTED]"'),
        (r'secret\s*=\s*["\'].*?["\']', 'secret="[REDACTED]"')
    ]

    sanitized = code
    for pattern, replacement in patterns:
        sanitized = re.sub(pattern, replacement, sanitized)

    return sanitized
성능 최적화
배치 처리
# 여러 요청을 배치로 처리
async def batch_code_review(files):
    import asyncio

    async def review_single(file_content):
        # 비동기 API 호출
        return await async_client.chat.completions.create(
            model="qwen3-coder-plus",
            messages=[{"role": "user", "content": f"Review: {file_content}"}]
        )

    tasks = [review_single(f) for f in files]
    return await asyncio.gather(*tasks)
캐싱 전략
from functools import lru_cache
import hashlib

@lru_cache(maxsize=1000)
def cached_code_generation(prompt_hash):
    # 동일한 프롬프트에 대한 캐싱
    return generate_code(prompt_hash)

def generate_with_cache(prompt):
    prompt_hash = hashlib.md5(prompt.encode()).hexdigest()
    return cached_code_generation(prompt_hash)
모니터링 및 품질 관리
# 사용량 및 품질 모니터링
class QwenMonitor:
    def __init__(self):
        self.metrics = {
            'total_requests': 0,
            'successful_completions': 0,
            'average_response_time': 0,
            'token_usage': 0
        }

    def log_request(self, request_data, response_data, duration):
        self.metrics['total_requests'] += 1
        if response_data.get('success'):
            self.metrics['successful_completions'] += 1

        # 토큰 사용량 추적
        self.metrics['token_usage'] += response_data.get('usage', {}).get('total_tokens', 0)

        # 평균 응답 시간 업데이트
        self.update_average_response_time(duration)

    def generate_report(self):
        return {
            'success_rate': self.metrics['successful_completions'] / self.metrics['total_requests'],
            'average_tokens_per_request': self.metrics['token_usage'] / self.metrics['total_requests'],
            'average_response_time': self.metrics['average_response_time']
        }
핵심 장점 요약
- 성능: Claude Sonnet 4와 비등한 수준의 코딩 능력
- 비용: Apache 2.0 라이선스로 무료 상업적 사용
- 확장성: 최대 100만 토큰 컨텍스트 지원
- 통합성: 주요 개발 도구와의 원활한 통합
적용 분야별 영향
| 분야 | 예상 영향 | 구체적 활용 |
|---|---|---|
| 스타트업 | 개발 비용 50% 절감 | MVP 빠른 구현 |
| 대기업 | 생산성 30% 향상 | 레거시 코드 현대화 |
| 교육 | 학습 곡선 완화 | 실시간 코딩 튜터 |
| 오픈소스 | 기여도 증가 | 자동 문서화, 버그 수정 |
바로 시작하기
Qwen3-Coder를 시작하는 가장 빠른 방법
# 1. API 키 발급 (Alibaba Cloud)
# 2. 간단한 테스트
curl -X POST https://dashscope-intl.aliyuncs.com/compatible-mode/v1/chat/completions \
  -H "Authorization: Bearer $YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3-coder-plus",
    "messages": [{"role": "user", "content": "Hello, write a Python function to calculate factorial"}]
  }'
Qwen3-Coder는 AI 코딩의 민주화를 실현하는 중요한 이정표입니다. 오픈소스 커뮤니티의 힘과 최첨단 AI 기술의 결합으로, 모든 개발자가 세계적 수준의 AI 코딩 어시스턴트를 활용할 수 있는 시대가 열렸습니다.


댓글