독감 예방접종 안내가 나간 직후 예약 페이지에 접속이 한꺼번에 몰리면, 서버에서 먼저 느려지는 곳은 한 군데가 아닙니다. 로드밸런서 대기열이 쌓이고, 웹 서버 워커가 모두 바쁘며, 애플리케이션이 DB 커넥션을 얻지 못해 기다리다가 타임아웃이 납니다. 사용자 화면에는 "잠시 후 다시 시도하세요"만 보이기 때문에 원인을 찾기 어렵습니다.
이 글은 예약 시스템을 맡은 담당자와 개발자가 장애가 나기 전에 확인할 순서를 정리합니다. 웹 서버 워커 수, DB 커넥션 풀, 타임아웃 값을 어떤 순서로 보면 병목을 빨리 찾을 수 있는지, 부하 테스트 전후에 무엇을 기록해야 하는지, 장애 때 어느 수준에서 조치할지 기준을 함께 다룹니다. 본문의 수치는 설명을 위한 예시이며, 실제 값은 여러분 시스템의 측정으로 정해야 합니다.
막히는 순서는 경로를 따라 확인합니다
요청이 사용자에서 DB까지 가는 경로를 따라 한 칸씩 보는 것이 가장 확실합니다. 보통 CDN 또는 로드밸런서, 웹 서버 워커, 애플리케이션 스레드나 프로세스, DB 커넥션 풀, DB 서버의 max_connections 순서입니다. 앞 단계의 한도가 뒤 단계보다 크면 트래픽이 그대로 뒤로 밀려 들어가고, 뒤 단계가 먼저 고갈됩니다.
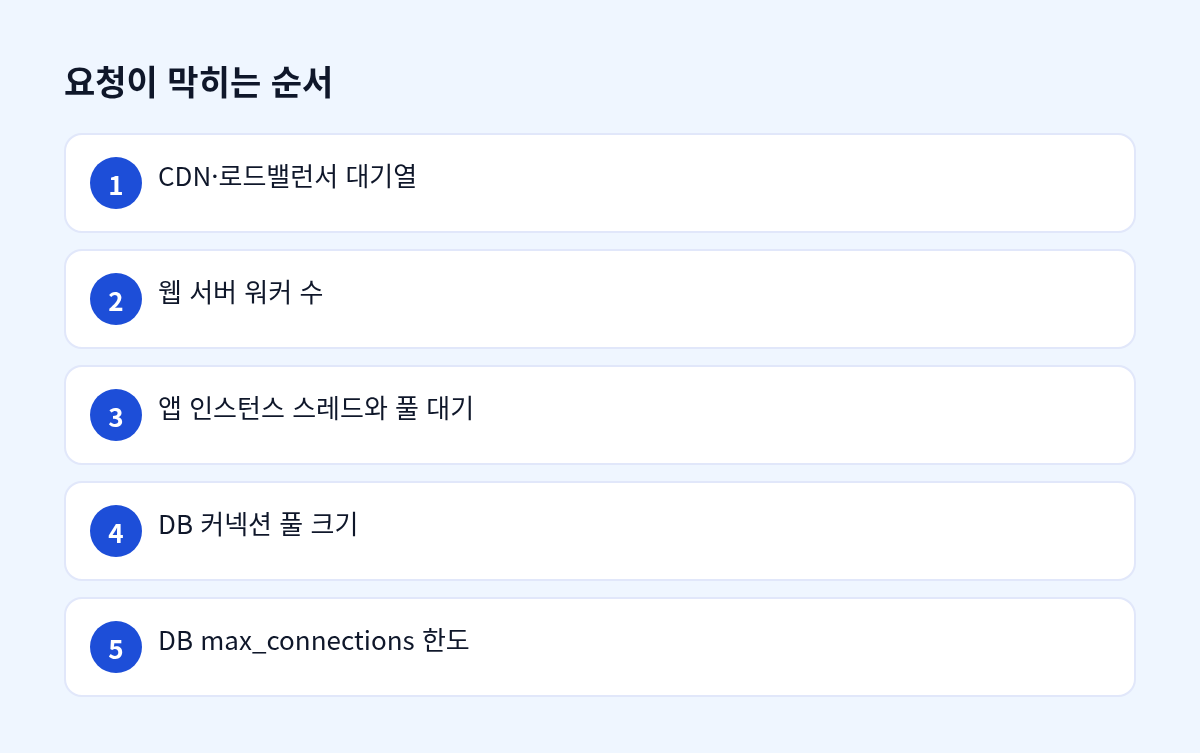
핵심은 가장 작은 한도가 어디에 있는지 찾는 것입니다. 웹 워커가 200개여도 인스턴스 여섯 대마다 DB 풀이 50개씩 있다면, 최대 300개의 연결 요청이 DB로 몰릴 수 있습니다. DB의 max_connections가 200이라면 웹 워커를 늘리는 순간 DB에서 먼저 막힙니다.
웹 서버 워커 수부터 확인합니다
웹 서버와 애플리케이션 서버의 워커(프로세스·스레드) 수, 동시에 받을 수 있는 연결 수, 대기열 길이를 확인합니다. Nginx라면 worker_processes와 worker_connections, Gunicorn이라면 workers와 threads, Tomcat이라면 maxThreads와 acceptCount가 해당합니다. 설정 파일 값만 보지 말고 실제로 떠 있는 프로세스 수와 설정이 맞는지도 확인해야 합니다.
워커 수는 코어 수에서 시작합니다
CPU를 많이 쓰는 작업이 중심이라면 워커를 코어 수보다 훨씬 늘려도 컨텍스트 전환 비용만 커지는 경우가 많습니다. 반대로 DB나 외부 API 응답을 기다리는 시간이 길다면 워커가 더 필요할 수 있습니다. 시작점은 코어 수 기준으로 잡고, 부하 테스트에서 응답 시간과 CPU 사용률을 함께 보며 조정하세요.
워커가 모두 찬 상태를 알아보는 법
워커가 모두 사용 중이면 CPU는 낮은데 응답 시간만 길어지는 모습이 나타납니다. 이때 활성 연결 수, 대기 중인 요청 수, 502·503·504 응답 비율을 같이 보면 웹 계층이 막힌 것인지 앱 계층이 막힌 것인지 구분할 수 있습니다.
DB 커넥션 풀과 max_connections를 계산합니다
커넥션 풀은 애플리케이션 인스턴스마다 따로 존재합니다. 따라서 "인스턴스 수 × 풀 최대 크기"를 계산하고, 그 합이 DB의 max_connections에서 관리자 접속과 배치 작업이 쓸 여유를 뺀 값보다 작은지 확인해야 합니다. 이 계산을 문서로 남겨 두면 스케일 아웃할 때 DB가 먼저 터지는 일을 막을 수 있습니다.
풀 크기는 무작정 키우면 안 됩니다. HikariCP 문서가 소개하는 풀 크기 산정 방식처럼 DB 코어 수에 비례하는 작은 값에서 출발해 실측으로 올리는 것이 일반적입니다. 연결이 많아지면 DB에서 락 경합과 메모리 사용이 늘어 처리량이 오히려 떨어지는 경우가 많습니다.
가상의 사례입니다. 예약 API 인스턴스가 8대이고 풀 최대 크기가 30이면 최대 240개 연결이 필요합니다. DB의 max_connections가 300이고 배치와 모니터링이 40개를 쓰고 있다면 남는 여유는 260개입니다. 이 상태에서 인스턴스를 2대 더 늘리자 연결 한도를 넘어 "too many connections" 오류가 났고, 예약 페이지 전체가 실패했습니다.
풀에서 연결을 기다리는 시간(연결 획득 타임아웃)도 함께 봅니다. 이 값이 길면 요청은 앱 안에서 대기만 하다가 사용자가 새로고침을 누르게 되고, 같은 요청이 쌓여 부하가 더 커집니다.
타임아웃이 연쇄적으로 막는 방식
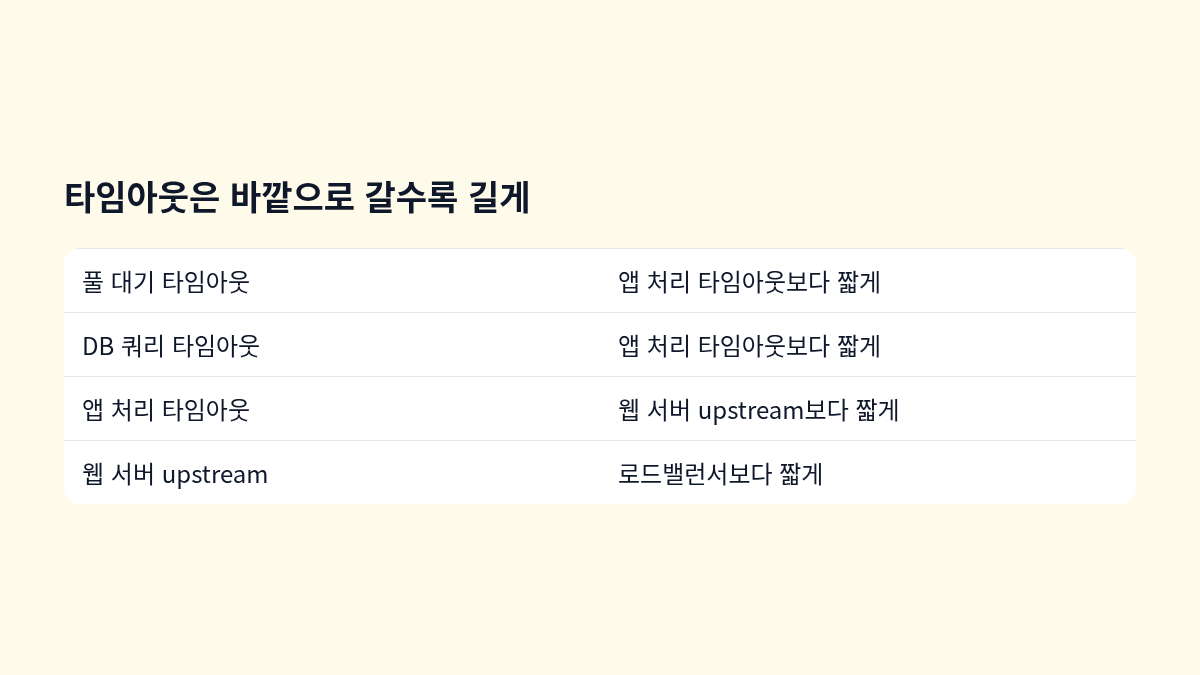
타임아웃은 계층마다 따로 설정되어 있습니다. 바깥쪽 값이 안쪽보다 짧으면 웹 서버가 먼저 끊고 앱에서는 작업이 계속 돌아갑니다. 사용자가 재시도를 누르면 같은 요청이 여러 개 남아 부하가 두 배 가까이 됩니다.
권장 구조는 안쪽 값이 짧고 바깥 값이 긴 형태입니다. 풀 대기, DB 쿼리, 앱 처리, 웹 서버 upstream, 로드밸런서 순서로 각 값이 바깥보다 짧게 잡혀 있는지 봅니다. 정확한 값은 시스템마다 다르므로, 정상 시기의 p99 응답 시간에 여유를 더한 값을 시작점으로 쓰는 것이 근거가 있습니다.
부하 테스트 전후에 확인할 항목
부하 테스트는 운영과 분리된 환경에서 하는 것이 원칙입니다. 운영에서 해야 한다면 대상 시간, 부하 규모, 중단 기준을 사전에 승인받고 기록해 두어야 합니다. 시나리오는 조회, 선택, 확인처럼 실제 예약 흐름과 비슷하게 만드세요. 메인 페이지만 반복 호출하면 실제 병목을 가리는 경우가 많습니다.
테스트 전에 기록할 것
웹 워커 수, 앱 인스턴스 수, 풀 최대 크기, DB max_connections, 각 타임아웃 값을 한 장에 적어 둡니다. 설정이 바뀐 상태로 테스트하면 다음 번 결과와 비교할 수 없으니, 설정 버전도 함께 남기세요.
테스트 중과 후에 볼 것
응답 시간의 p95와 p99, 오류율, 활성 DB 연결 수, 풀 대기 시간, 워커 사용률을 같은 시간축에 맞춰 봅니다. 연결 수가 한도에 닿은 시점과 오류가 처음 나타난 시점이 같다면 그 계층이 병목입니다. 결과는 가용성 점검의 증적으로 보관해 두면 다음 점검 때 비교할 수 있습니다.
장애 시 응답 기준
장애가 났을 때 무엇을 할지는 미리 정해 두어야 합니다. 아래 표의 수치는 구조를 보여 주기 위한 예시이며, 실제 기준은 서비스 목표와 자사 측정값에 맞춰 정합니다.
| 상황 | 확인 지표 | 1차 조치 | 에스컬레이션 기준 |
|---|---|---|---|
| 응답 지연 증가 | p95 응답 시간, 워커 사용률 | 정적 응답 캐시 적용, 대기열 확인 | 정상 시기 p95의 배 이상이 일정 시간 지속 |
| 풀 대기 증가 | 풀 대기 시간, 활성 연결 수 | 느린 쿼리 차단, 불필요 배치 중지 | 풀 대기 시간이 0에 가깝지 않은 상태가 지속 |
| DB 연결 한도 근접 | DB 연결 수와 max_connections 비율 | 인스턴스 증설 보류, 배치 정지 | 여유분을 넘는 연결 오류가 발생 |
| 5xx 급증 | 502·503·504 비율, 오류 로그 | 트래픽 제한, 예약 대기 안내 전환 | 5xx 비율이 기준을 넘고 회복되지 않음 |
바로 해 볼 순서
- 웹 워커 수, 앱 인스턴스 수, 풀 최대 크기, DB max_connections를 한 장에 적습니다.
- 인스턴스 수 × 풀 크기가 DB 한도에서 관리자·배치 여유를 뺀 값을 넘지 않는지 계산합니다.
- 타임아웃을 안쪽부터 바깥 순서로 나열해, 바깥 값이 안쪽보다 짧은 역전 구간이 없는지 확인합니다.
- 예약 흐름과 비슷한 시나리오로 스테이징에서 부하 테스트를 하고, 지표를 시간축으로 기록합니다.
- 장애 기준과 1차 조치 담당자를 문서로 정하고, 알림 임계치를 그 기준에 맞춥니다.
자주 묻는 질문
웹 서버 워커를 크게 늘리면 해결되나요?
대개 해결되지 않습니다. 뒤쪽 DB 연결이 늘어나지 않으면 대기 요청만 많아지고 타임아웃이 함께 늘어납니다. 웹 워커 증설은 DB 한도와 풀 계산이 끝난 뒤에 하세요.
커넥션 풀을 크게 잡으면 안전한가요?
오히려 위험할 수 있습니다. 연결 하나가 DB 메모리와 락을 차지하므로 풀이 커지면 쿼리 자체가 느려지는 경우가 많습니다. 풀 크기는 실측으로 올리고, 풀 대기 시간이 낮게 유지되는지 함께 확인하세요.
장애 기준은 어떤 수치로 정해야 하나요?
서비스가 보장하려는 응답 시간과 오류율을 기준으로 정합니다. 목표치는 내부 SLO나 운영 계약에서 가져와야 하며, 외부의 일반 수치를 그대로 옮기기보다 자사 정상 시기의 측정값을 기준으로 삼는 편이 근거가 분명합니다.
정리
- 병목은 한도가 가장 작은 계층에서 먼저 생기므로, 요청 경로를 따라 한도를 순서대로 확인합니다.
- 인스턴스 수 × 풀 크기가 DB max_connections의 여유분을 넘지 않도록 계산하고, 바깥 타임아웃이 안쪽보다 길게 유지되도록 맞춥니다.
- 부하 테스트 전후 설정과 지표를 기록하고, 장애 기준을 문서로 정해 둡니다.
오늘 할 일: 웹 워커 수, 풀 최대 크기, DB max_connections를 한 장에 적고 인스턴스 수와 곱해 DB 한도와 비교해 보세요.


댓글