입력 형식 검사만으로는 부족한 이유
PHP 프로젝트를 점검하다 보면 unserialize()가 사용자가 보낼 수 있는 값을 그대로 받는 코드를 자주 만나게 됩니다. 쿠키에 저장된 장바구니 정보, 폼에서 넘어온 임시 저장 데이터, 외부 캐시 문자열이 대표적입니다. 이 함수는 직렬화된 문자열을 객체로 되살리면서 해당 클래스의 매직 메서드를 실행시킬 수 있어, 입력을 통제하지 못하면 객체 주입(PHP Object Injection) 취약점으로 이어질 수 있습니다.
이 글에서는 입력이 unserialize()까지 도달하는 지점을 찾는 순서, 출처별 위험도를 나누는 기준, allowed_classes로 객체 생성 범위를 좁히는 방법, json_decode()로 전환할지 판단하는 기준을 정리합니다. 중간마다 grep 명령과 PHP 코드를 넣었으니 개발팀과 함께 보면서 바로 적용해 보실 수 있습니다.
unserialize() 앞에서 문자열 길이나 정규식으로 형식만 확인하는 경우가 많습니다. 하지만 직렬화 문자열은 O:로 시작하는 객체 표기를 그대로 담고 있어, 형식이 맞더라도 공격자가 원하는 클래스 이름과 속성 값을 고를 수 있습니다. 형식 검사는 잘못된 문자열을 걸러내는 데는 도움이 되지만, 어떤 객체가 만들어지는지는 막지 못합니다.
그래서 점검 질문은 "이 값이 안전한 형식인가"가 아니라 "이 값으로 어떤 객체가 만들어질 수 있는가"여야 합니다. __wakeup(), __unserialize(), __destruct() 같은 메서드가 호출되는 클래스가 프로젝트나 의존 라이브러리 안에 있다면, 그 메서드가 파일 조작, DB 쓰기, 외부 호출을 하는지 확인해야 합니다. 여러 클래스의 메서드가 연쇄적으로 이어지는 형태를 가젯 체인이라고 부르며, 단일 클래스만 보면 안전해 보여도 조합되면 위험해질 수 있습니다.
1단계: 호출 지점과 입력 출처 찾기
먼저 코드 전체에서 호출 지점을 빠짐없이 찾습니다. 프로젝트 루트에서 아래 명령으로 1차 목록을 만들고, 프레임워크나 CMS를 쓴다면 vendor 디렉터리와 플러그인 경로도 함께 검색하세요.
grep -rn "unserialize(" --include="*.php" .
함수 이름만 검색하면 놓치는 경로도 있습니다. 세션 값을 복원하는 session_decode(), CMS가 자체 래퍼로 감싼 maybe_unserialize(), 캐시·큐·DB 컬럼에서 꺼낸 값을 바로 복원하는 코드가 그렇습니다. 파일 함수에 사용자 입력 경로가 들어가는 경우도 확인해야 합니다. phar:// 경로가 file_exists()나 is_file() 같은 함수에 전달되면 phar 메타데이터가 역직렬화되는 경로가 열릴 수 있습니다.
목록을 만든 뒤에는 각 지점의 입력 출처를 역추적합니다. 출처는 세 가지로 나누면 판단이 쉬워집니다. 첫째, 클라이언트가 직접 바꿀 수 있는 값(쿠키, 헤더, GET·POST, 업로드 파일)입니다. 둘째, 사용자가 간접적으로 바꿀 수 있는 값(사용자가 입력해 DB에 저장된 값, 외부 API 응답)입니다. 셋째, 서버가 만들고 서명까지 붙여 내부에서만 쓰는 값입니다.
가상의 예: 한 쇼핑몰이 장바구니 상품 목록을 PHP serialize 문자열로 만든 뒤 base64로 인코딩해 쿠키에 저장하고, 요청마다 unserialize()로 복원하고 있었습니다. 담당자는 서버가 만든 값이라 내부 데이터라고 생각했지만, 쿠키는 클라이언트가 수정할 수 있으므로 이 지점은 첫째 출처, 즉 외부 입력 경로로 분류해야 합니다.
allowed_classes로 객체 생성 범위 좁히기
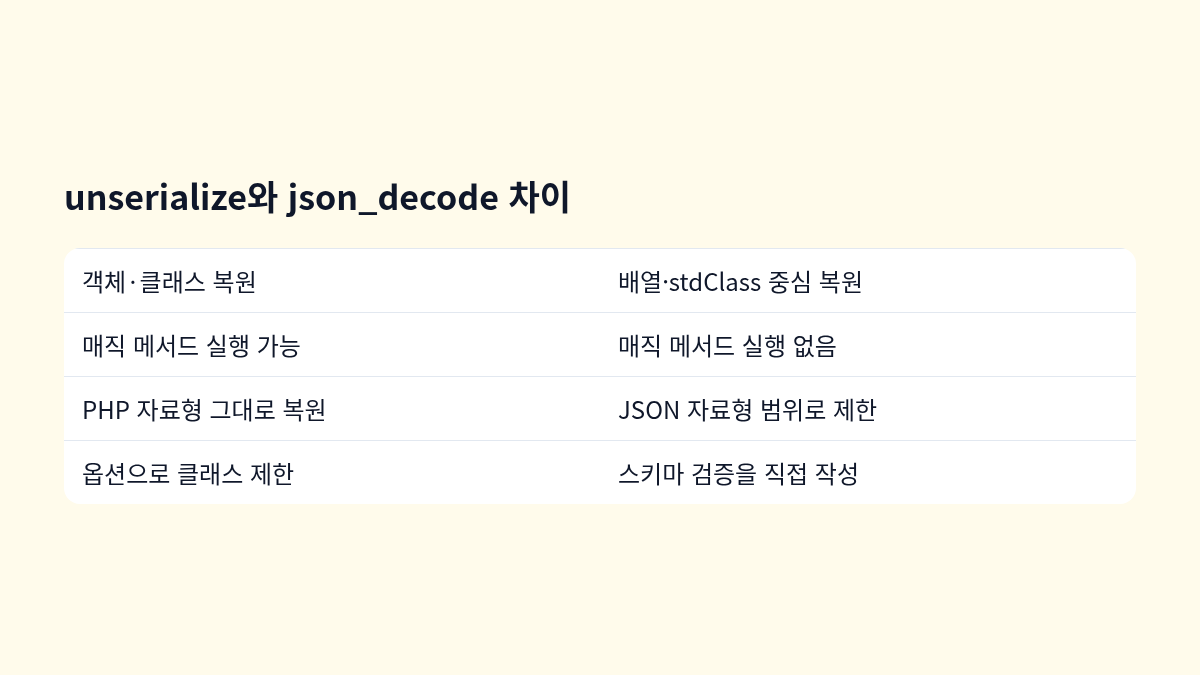
PHP 7.0부터 unserialize()의 두 번째 인자로 옵션 배열을 줄 수 있고, 그 안의 allowed_classes로 복원을 허용할 클래스를 지정할 수 있습니다. 값을 false로 주면 모든 객체가 __PHP_Incomplete_Class로 복원되어 원래 클래스의 메서드가 실행되지 않습니다. 허용할 클래스만 배열로 지정하면 그 밖의 클래스는 같은 방식으로 막힙니다.
$data = unserialize($raw, ['allowed_classes' => false]);
$data = unserialize($raw, ['allowed_classes' => ['App\Model\CartItem']]);
주의할 점이 있습니다. 허용 목록에 넣은 클래스는 여전히 매직 메서드가 실행되므로, 그 클래스의 __destruct()나 __wakeup()에서 파일 쓰기나 외부 호출을 하지 않는지 코드를 직접 읽어야 합니다. 목록에는 실제로 객체가 필요한 클래스만 넣고, 가능하면 false로 두는 것이 원칙입니다. allowed_classes는 방어 한 겹일 뿐이므로, 외부 입력이라면 unserialize() 자체를 쓰지 않는 것이 가장 확실합니다.
서버가 만든 내부 데이터를 어쩔 수 없이 unserialize()해야 한다면, 복원 전에 HMAC 서명을 먼저 검증하세요. 서명 비교는 hash_equals()로 합니다. 이 방식은 서명 키가 안전하게 보관될 때만 의미가 있으므로, 키가 소스 코드나 공개 저장소에 들어 있지 않은지도 점검 항목에 넣어야 합니다.
json_decode로 전환할지 판단하는 기준
전환 여부는 데이터의 출처와 객체 복원이 실제로 필요한지로 판단합니다. 외부에서 들어오는 값이라면 원칙적으로 json_decode()로 바꾸는 것이 맞습니다. 반대로 객체 타입과 내부 참조 관계를 유지해야 하는 도메인 객체라면 전환 비용이 크므로, allowed_classes를 명시한 채 전환 일정을 따로 잡는 것이 현실적입니다.
json_decode()로 바꿀 때는 두 번째 인자를 true로 주어 배열로 받고, 실패 시 예외가 발생하도록 JSON_THROW_ON_ERROR 플래그를 함께 씁니다. 이 플래그는 PHP 7.3 이상에서 사용할 수 있습니다.
$arr = json_decode($raw, true, 512, JSON_THROW_ON_ERROR);
전환 후에는 구조 검증을 반드시 넣어야 합니다. 예를 들어 if (!is_array($arr) || !isset($arr['product_id'], $arr['qty'])) 형태로 필수 키와 타입을 확인하고, 맞지 않으면 즉시 거부합니다. json_decode()를 썼다고 입력 검증이 자동으로 끝나는 것은 아닙니다.
아래 표는 출처와 상황별로 어떤 방식을 택할지 정리한 것입니다.
| 데이터 출처 | 권장 방식 | 판단 근거 |
|---|---|---|
| 쿠키, 헤더, 폼, 쿼리 값 (외부 요청) | json_decode(assoc=true) + 스키마 검증 | 객체 생성 경로 자체를 없앰 |
| 외부 API 응답 | json_decode + 필드 타입 검증 | 상대 시스템 변경과 오류 응답에 대비 |
| 서버가 서명한 내부 캐시 | 서명 검증 후 unserialize + allowed_classes 명시 | 객체 복원이 꼭 필요한 경우만 허용 |
| 과거 serialize 데이터 마이그레이션 | allowed_classes false로 읽고 새 형식으로 재저장 | 읽기 기간을 정해 두고 이후 제거 |
| 파일 경로에 사용자 입력이 들어가는 경우 | 경로 화이트리스트 적용, phar:// 접두어 거부 | 파일 함수가 역직렬화를 유발할 수 있음 |
바로 해 볼 점검 순서
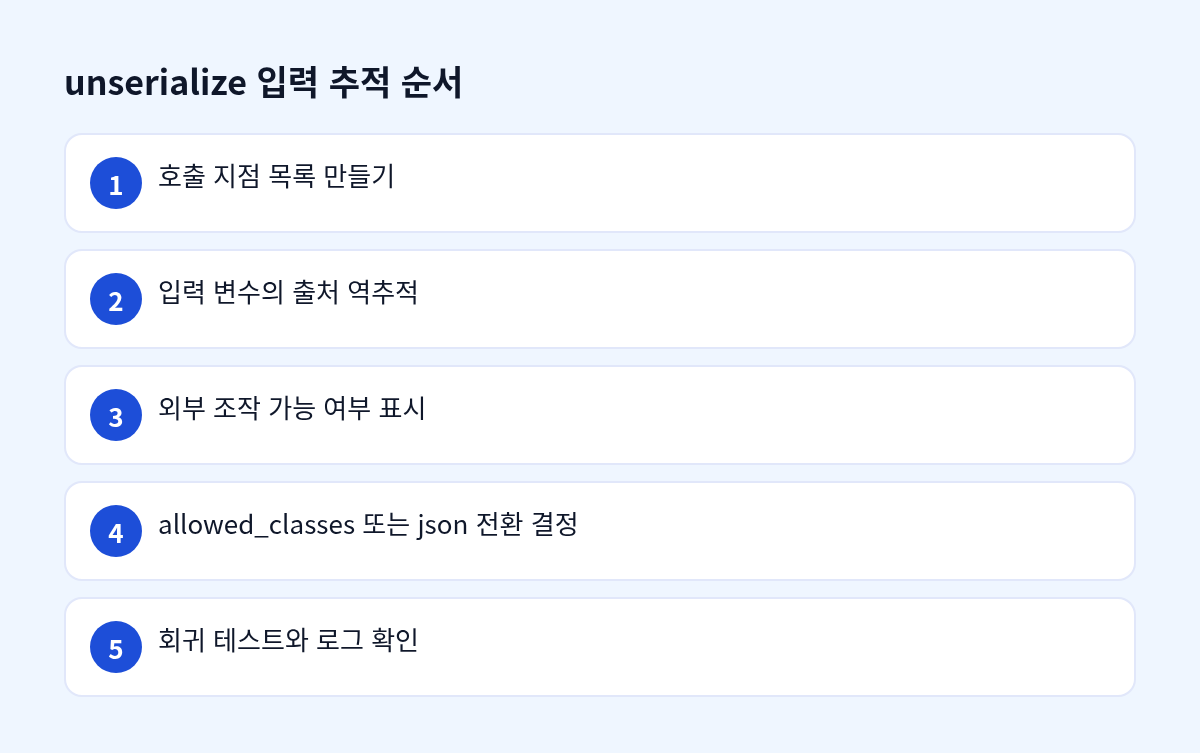
- grep으로 unserialize( 호출 지점, session_decode, maybe_unserialize를 포함한 목록을 만들고 파일 경로와 함께 기록합니다.
- 각 지점의 입력 변수를 역추적해 쿠키, 요청, DB, 외부 API, 서버 내부 중 어디에서 오는지 출처를 표시합니다.
- 외부 출처 지점은 json_decode 전환 대상으로 두고, 스키마 검증 코드를 함께 작성합니다.
- 내부 출처 지점은 allowed_classes 목록을 명시하고, 목록에 든 클래스의 매직 메서드를 읽어 파일·DB·외부 호출 여부를 확인합니다.
- 전환 전후로 테스트 데이터를 넣어 기존 기능이 동작하는지 확인하고, 변경 내역과 점검 결과를 증적으로 보관합니다.
자주 묻는 질문
allowed_classes를 설정했다면 이제 안전한가요?
아닙니다. allowed_classes는 객체 생성 범위를 줄여 주지만, 허용된 클래스의 매직 메서드는 여전히 실행됩니다. 외부 입력이라면 json_decode로 바꾸는 것이 우선이고, allowed_classes는 객체 복원이 꼭 필요한 내부 데이터에 보조 수단으로 쓰는 것이 맞습니다.
기존 serialize 데이터가 DB와 세션에 많이 남아 있는데 한꺼번에 바꿔도 되나요?
한꺼번에 바꾸면 기존 세션이 끊기거나 저장 데이터를 읽지 못하는 문제가 생길 수 있습니다. 읽을 때는 allowed_classes false로 호환하고, 쓸 때는 새 형식으로 저장하는 방식으로 일정 기간 병행하세요. 옛 형식으로 읽는 호출이 로그에서 사라진 뒤에 호환 코드를 제거하는 순서가 안전합니다.
외부 라이브러리 내부에서 unserialize를 쓰고 있으면 어떻게 하나요?
먼저 해당 라이브러리가 어떤 입력을 복원하는지 확인하고, 그 입력이 외부 사용자에게서 올 수 있는지 판단합니다. 버전을 올릴 수 있는지, 공식 저장소나 보안 공지에 관련 내용이 있는지도 확인하세요. 해당 제품에 취약점이 있는지는 제조사나 배포처의 공식 공지로 확인하는 것이 확실합니다.
정리
- unserialize()는 형식 검사가 아니라 "어떤 객체가 만들어지는가"를 기준으로 점검합니다.
- 외부 입력은 json_decode로 전환하고 스키마 검증을 붙이며, 내부 데이터만 allowed_classes와 서명 검증으로 제한합니다.
- 허용 목록에 든 클래스의 매직 메서드까지 읽어야 점검이 끝납니다.
오늘 할 일: 저장소에서 unserialize( 검색 결과를 출처별로 나눈 표를 만들어 보세요. 외부 출처가 하나라도 나오면 그 지점부터 json_decode 전환을 검토합니다.


댓글